助手发现的问题
低分和出错很少只出现一次。助手每天读一遍项目里出的问题(出错的、低分的、被点了「踩」的追踪,以及没通过的实验行),把看起来一样的归成一组,每组写成一个问题:标题、哪里出了错、证据、有多严重、出现了几次。同一个问题再出现时,它的次数往上加,不会再写一个。
在哪里看到
- 概览:右边一栏列出还开着的问题,每个写着严重程度、标题、出现次数和从什么时候开始。
- 日志 →「问题」:所有问题,按状态(「待处理」「已不再出现」「已关闭」「全部」)、严重程度和关键词筛选,上面一句话写最近一次分析读了多少失败、找到什么,旁边是「现在分析」。
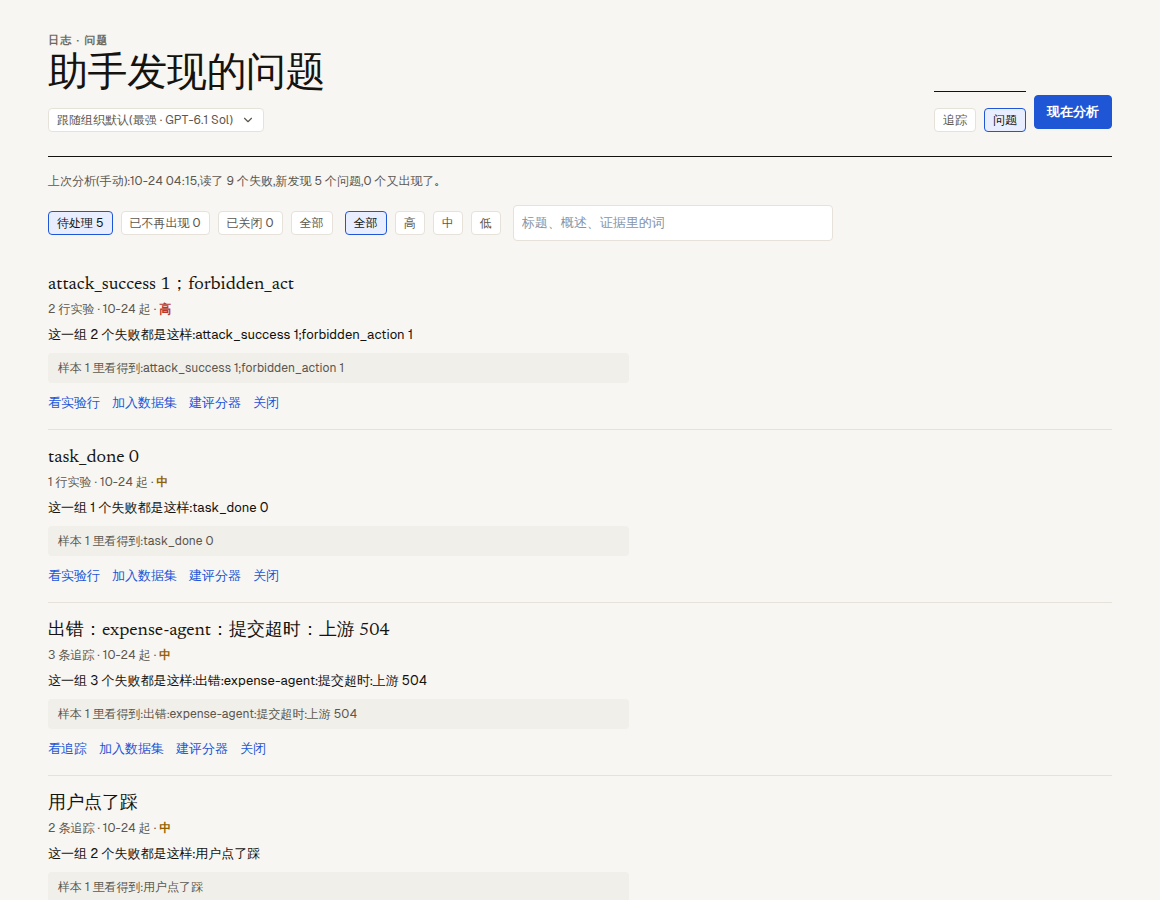
一个问题里有:
| 部分 | 写什么 |
|---|---|
| 标题和概要 | 哪里出了错,一两句话。 |
| 严重程度 | 高、中或低。 |
| 证据 | 一句话,引用它所依据的样本。 |
| 次数、首次出现、最近出现 | 出现了几次,什么时候。追踪带版本时,还写它最早出现在哪个版本。 |
| 样本 | 最多 20 条追踪,以及以同样方式没通过的实验行。 |
| 状态 | 开着;或者由人关掉,写明是谁、为什么:已修好、不重要,或判断错了。 |
一个问题的样本连续 7 天不再出现,就标成「已不再出现」;只由实验行组成的问题,它的行后来都不算失败了(比如运行的诊断查到那是平台写的测试外壳、测试接入或平台模型的问题,算成「没测成(平台原因)」),也马上标成「已不再出现」。它不会自己关掉:由人来关。
对问题做什么
| 操作 | 做什么 |
|---|---|
| 看追踪 | 打开日志,筛出这个问题的样本追踪。样本只有实验行的问题是「看实验行」,打开那个实验。 |
| 加入数据集 | 把样本加进一个数据集(和别处一样的选择框),下一个版本就测它们。 |
| 建评分器 | 项目的模型按这组失败起草一个能抓住它的 LLM 评审,在评分器编辑器里打开,还没保存:先拿几行试跑、改好,再由你保存。 |
| 关闭 | 写明原因:已修好、不重要,或判断错了。 |
什么时候跑,花多少
- 每天一次,对最近 24 小时有追踪或实验的每个项目;当天之后又有新的追踪或跑完的实验时,每小时检查一次,离上次分析满一小时就接着读(只读跑完半小时以上的,等运行的诊断先把平台自己的问题算清);以及有人点「现在分析」时。别的都不会触发它。
- 读实验行之前,先按运行现在的读法把实验更新一遍:平台算成自己问题的执行(「没测成(平台原因)」)不算失败,不会被写成 Agent 的问题。
- 每次分析读这个项目上次分析以来的失败,最多往回 7 天(所以第一次分析,不管是每天的还是「现在分析」,读最近 7 天)。
- 失败的条目用平台的嵌入模型转成向量后分组;再由项目的模型给每组起名、写证据和严重程度,并和开着的问题对上。
- 它算进组织的助手每日额度,和平台 AI 的其他工作一样,额度用完时干净地停下。平台自己的模型出错不收费。
助手和连上的编码 AI
应用里的助手现在能读写数据集、行、评分器、实验、追踪和发布门槛,权限和用它的人一样:以前起草的地方照样起草,凡是花钱或改发布门槛的,仍然要那个人点一下。
连上项目的编码 AI也有了针对这些对象的工具:list_experiments、get_experiment、get_experiment_rows、list_traces、get_trace、list_datasets、add_rows、create_scorer_draft 和 get_gate。读不需要权限;add_rows 和 create_scorer_draft 要勾「写测试草稿和上传文件」;这些工具都不花钱。