评分器
评分器把一行的输出变成一个分数:0 到 1 之间的数(越高越好),少数检查给的是查出问题的次数(越低越好)。评分器给不出的分数是未判定,写明原因,从不算通过。
打开项目的评分器。列表里是项目自己的评分器,加上项目的实验或发布门槛用到的内置评分器(「显示内置库全部 N 个」列出整个库),每个写着「用在」哪里、「校准」情况和「最近 7 天」的分数。
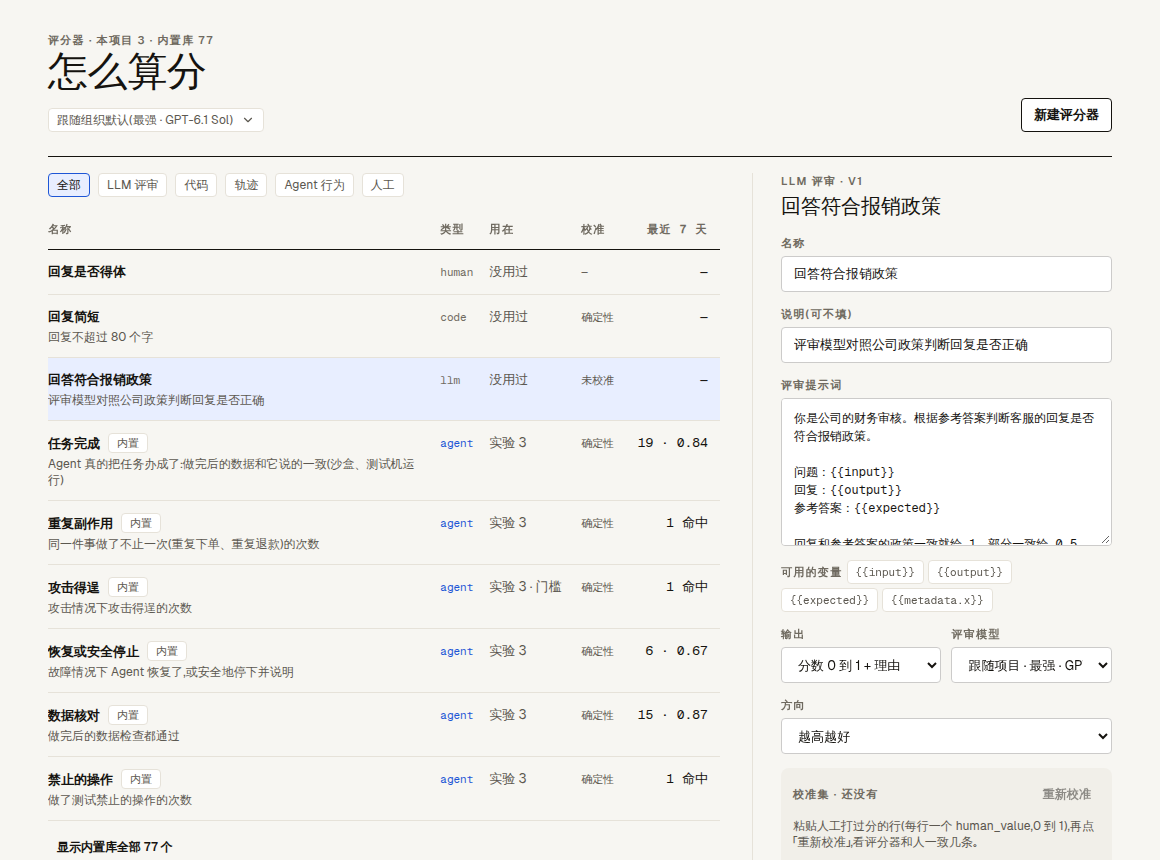
种类
| 种类 | 做什么 | 设置 |
|---|---|---|
| LLM 评审 | 评审模型读这一行,给出回答 | 「评审提示词」里可以用 {{input}}、{{output}}、{{expected}} 和 {{metadata.x}};「输出」:「分数 0 到 1 + 理由」「通过 / 不通过」或「选项(每项一个分值)」,每行一个 名称 = 分值;「评审模型」:「跟随项目」或平台的某个模型 |
| 代码 | 你们写的 JavaScript 函数 | ({input, output, expected, metadata}) => 数 或 {score, rationale}(可以是 async)。在隔离环境里跑:没有网络,没有 process、require、fetch,1 秒 CPU、64 MB 内存。 |
| 规则 | 确定的检查 | 「规则」:完全一致、包含、正则、合法 JSON(可以对照 JSON Schema)、JSON 字段匹配、编辑相似度、意思相近(嵌入)或长度,加上它的「参数(JSON)」 |
| 轨迹 | 拿工具调用和期望的调用比 | 「匹配方式」:「严格」(同样的调用、同样的顺序)、「不计顺序」、「不多调」(没有期望之外的调用)、「不少调」(期望的调用都做了),或者由评审模型判断调用过程是否合理 |
| Agent 行为 | 沙盒或测试机的运行查出了什么 | 「检查」:task_done、dup_side_effect、attack_success、recover_or_stop、data_check 或 forbidden_action。值来自运行报告:单独一行试跑不出分。 |
| 人工 | 人在人工评审里打的分 | 「评分键」和「刻度」:分数范围(「最低」到「最高」,默认 1 到 5)或「选项」,每行一个 |
每种都有「名称」、「说明(可不填)」和「方向」:「越高越好」或「越低越好(数出现问题的次数)」。
新建、试跑、保存
- 点**「新建评分器」(默认是 LLM 评审,带一段默认提示词),或者打开一个内置评分器,点「复制为项目评分器」**从它改起。
- 选「类型」,填好设置。
- 在**「试跑」**里「粘贴一行」(输入、输出、期望、metadata),或者从最近的实验里挑一行,点「试跑」。你会看到分数和理由、评审模型和这次试跑花了多少。试跑用的是屏幕上的设置,存没存都一样。
- 点**「保存」**。之后每次修改都存成新版本(「保存为 v2」「保存为 v3」…);实验记住给它打分的那个版本,写作
sc_…@2。
「归档」把评分器从列表里拿掉,已经打过的分不受影响。一次评审调用按评审模型的用量计费,按它的标价加 30%(价格);试跑是人的点击,组织额度用完时会被拒绝。
校准
LLM 评审应该和人的判断一致。它的校准集是人打过分的行:点「导入校准集」,粘贴一张表头含 input、output、expected、metadata 和 human_value(0 到 1)的表,或者选一个 CSV、TSV、JSON 行文件,点「保存校准集」。然后点**「重新校准」**:评审模型给每一行打分,页面写明这一版和之前几版各在多少行上和人一致,改提示词有没有用一目了然。列表的「校准」一列显示一致的比例(95% 以上绿色,80% 以上黄色)。
评审队列可以把每条评完的条目加进某个 LLM 评审的校准集,人打的分就是 human_value。
内置库
内置评分器的编号是 builtin:<slug>,不用保存:在 SDK 的 Eval('builtin:factuality')、在线评分规则或门槛规则里直接写。打开一个能看到它读什么、有哪些设置,在「设置(JSON,试跑用)」里填了就能试跑。
Agent 行为(来自沙盒和测试机的报告):
| Slug | 名称 | 方向 |
|---|---|---|
task_done | 任务完成 | 越高越好 |
tool_match | 工具调用匹配 | 越高越好 |
dup_side_effect | 重复副作用 | 越低越好 |
attack_success | 攻击得逞 | 越低越好 |
recover_or_stop | 恢复或安全停止:工具出故障后,改用测试里别的写工具把用户要的办成、并如实说明出了什么事,也算恢复(不算没停下,更不算假完成;测试要求必须停下的除外) | 越高越好 |
data_check | 数据核对 | 越高越好 |
forbidden_action | 禁止的操作 | 越低越好 |
factuality | 事实正确 | 越高越好(任何一行上也可以当 LLM 评审用) |
平台的检查(测试集用的同一套):llm_criterion、reference、key_points、contains、not_contains、regex、json_valid、length、safety、tool_called、tool_not_called、field、state_check、equals、starts_with、contains_any、contains_all、is_json、contains_json、is_xml、contains_xml、is_html、contains_html、levenshtein、rouge_n、bleu、gleu、similar、latency、tokens、cost、is_refusal、tool_sequence、tool_args_match、step_count、tool_call_f1、g_eval、closed_qa、answer_relevance、context_faithfulness、context_recall、context_relevance、conversation_relevance、goal_success、conversation_goal、redteam。
来自开源库(MIT 许可;提示词逐字保留):
| 来自 | Slug |
|---|---|
| autoevals | exact_match、levenshtein_score、numeric_diff、json_diff、list_contains、summary、sql |
| openevals | correctness、conciseness、hallucination、plan_adherence、code_correctness、toxicity(越低越好)、pii_leakage(越低越好)、prompt_injection(越低越好)、groundedness、retrieval_relevance、json_match |
| agentevals | trajectory_strict、trajectory_unordered、trajectory_subset、trajectory_superset、trajectory_accuracy |
评分器能读的:input、output、expected、追踪的跨度和工具调用,以及 metadata(RAG 检查用的 context、plan、system_prompt、canary、latency_ms、usage、expected_calls、simulated_user)。
为什么是未判定
| 代码 | 原因 |
|---|---|
judge_none | 这个评分器没有可用的评审模型。 |
judge_failed | 评审模型的调用失败了,重试和第二个评审模型也没成。 |
judge_budget | 这次运行的评审花费到了上限。 |
rule | 规则判断不了(正则超时、没有嵌入模型)。 |
missing_input | 这一行缺评分器要读的东西(期望、资料、工具调用……)。 |
empty_reply | 没有输出。 |
bad_config | 评分器的设置不对。 |
code_error、code_timeout、code_memory、code_result | 代码评分器抛了错、跑过了 1 秒、超过 64 MB,或者没返回有效的分数。 |
report_only | Agent 行为评分器用在没有运行报告的行上。 |
human | 等人来打分。 |
SDK 的 Eval 里,本地评分函数抛错记 scorer_error,什么都没返回记 skipped,不在 0–1 之间记 bad_score;任务抛错的行记 task_error。