日志
日志列出你们的应用发来的追踪:一次请求或一次 Agent 运行一条追踪,由跨度组成(Agent 本身、每次模型调用、每次工具调用、每次检索),带输入输出、状态、延迟、token 和成本。
追踪通过 SDK、AI Gateway 或 OpenTelemetry 发来,用能上传的项目令牌。第一条到之前,页面给出这三种方式,项目的值已经填好;「接入新来源」在目标里打开它们。从日志快速开始入手。
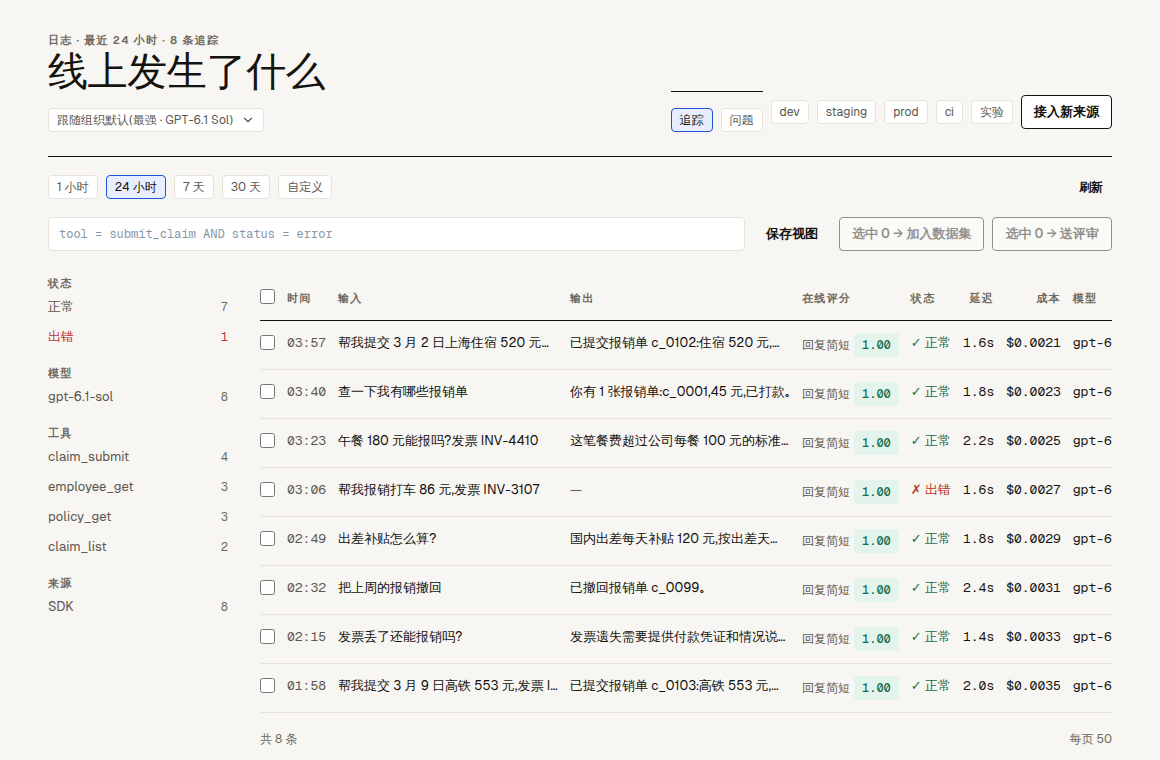
找追踪
- 时间范围:「1 小时」「24 小时」(默认)「7 天」「30 天」或「自定义」(最长 31 天),以及「刷新」。
- 环境:芯片
dev、staging、prod、ci和「实验」(SDK Eval 里的行的追踪)。都不选就是全部。 - 筛选追踪:用筛选语法,比如
tool = submit_claim AND status = error、model ~ gpt AND score.builtin:correctness < 0.5或output ~ "退款"。写错的部分会划线,并写明为什么。input和output只搜表格里「输入」「输出」显示的前 500 个字符。 - 分面:按状态、模型、工具、来源(OpenTelemetry、SDK、Gateway)、低于 0.5 的在线评分、标签和版本计数。点一项就加进筛选。
- 状态:「正常」「出错」,或「调用方取消」(
status = cancelled):调用方在调用结束前自己停了,比如 AI Gateway 的流还没到最后一句,调用方就关了连接。这不算成功也不算出错:概览的错误率、错误率告警和助手发现的问题都不算它,在线评分也不给它打分。 - 保存的视图:「保存视图」把筛选、环境芯片和时间范围存成一个名字,「打开保存的视图」再找回来。视图只存在这台浏览器里。
表格有「时间」「输入」「输出」「在线评分」「状态」「延迟」「成本」「模型」和「版本」,每页 50 条。模型调用(经 AI Gateway 的调用,或带 GenAI 约定消息的跨度)的「输入」是最后一条用户消息,「输出」是回复的文字,工具调用写成 名字(参数);系统提示词、参数和 Gemini 的思考签名只在追踪侧栏里。别的照发来的样子显示。
一条追踪
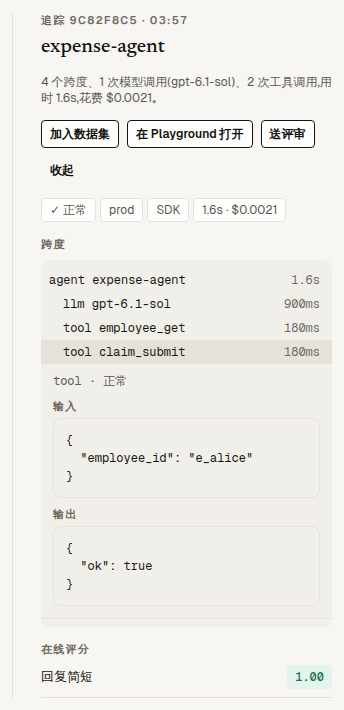
点一行。侧栏开头一句话概括(「8 个跨度、2 次模型调用(gpt-6.1-sol)、3 次工具调用,用时 4.2 秒,花费 $0.004」,哪个跨度出错、为什么),然后是:
- 跨度:按层级缩进的树。点一个跨度看它的种类、模型、输入输出 token(和缓存的)、成本、状态、输入输出和属性。太大放不进来的内容存在存储里,点「展开」读回来。
- 在线评分:每个分数和理由、评审模型,来自在线评分和人工评审。
- 元数据,追踪属于 SDK Eval 的某一行时还有「来自实验」。
对追踪做什么
| 操作 | 在哪里 | 做什么 |
|---|---|---|
| 「加入数据集」 | 追踪侧栏,或勾选几条后点「选中 N → 加入数据集」 | 把它们的输入输出复制成数据集的行(来源「日志」),下一个版本就拿真实发生过的事来测。一次最多 500 条。 |
| 「送评审」 | 侧栏,或「选中 N → 送评审」 | 放进一个人工评审队列。 |
| 「在 Playground 打开」 | 侧栏 | 在 Playground 里打开这条追踪:它的系统提示词和模型作为 A 列,它的输入作为第一行。 |
一条追踪记下什么
| 从哪里来 | 记下什么 |
|---|---|
| AI Gateway | 一次调用一条追踪、一个跨度:模型、token、成本、请求和回复。环境标签来自请求头 x-preworld-environment。 |
| OpenTelemetry | 你们发来的跨度,按 Vercel AI SDK、OpenInference、OpenLLMetry 或 OpenTelemetry GenAI 约定读;环境标签来自 deployment.environment.name。有已知模型和 token 的模型跨度会算出成本。 |
| SDK | traced 函数和包装过的客户端记成跨度;在 Eval 里,每个跨度连到它的实验行。 |
追踪按组织的保留期保存(默认 90 天,见保留期),到期删除。上传的数据量记作「上传的追踪」,现在不收费(见价格)。
下一步
- 在线评分与告警:追踪一进来就抽样打分。
- 助手发现的问题:助手在追踪里找出的问题。
- OpenTelemetry 与 AI Gateway:地址、请求头和上限。