Playground
Playground 把几种提示词和模型并排放在同一批行上跑,给每一格打分,每一列都能存成实验。发布之前先拿它试一下改过的提示词或更便宜的模型。
打开项目的 Playground。它打开你最近的会话;「会话」菜单在会话之间切换,「+ 新建会话」另开一个。会话边改边存(「已保存」)。
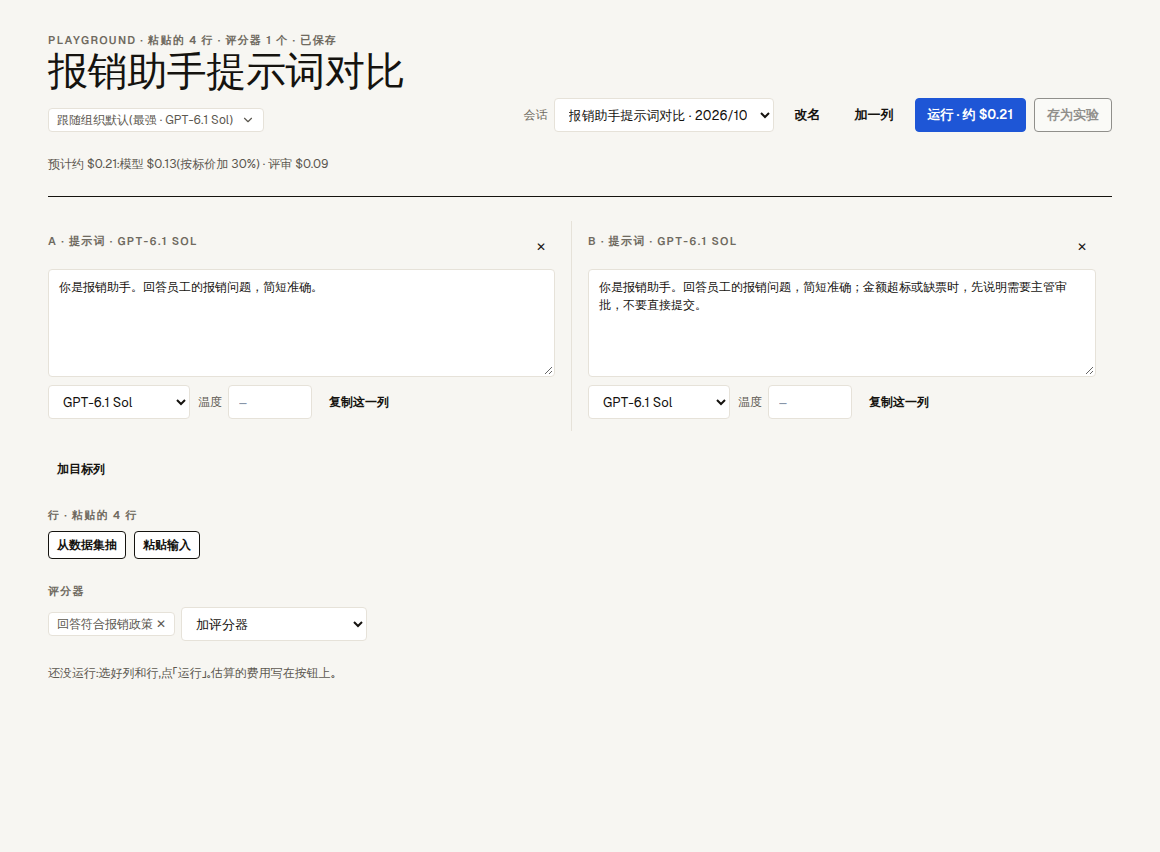
列
每一列是一个变体,编号 A 到 F(最多 6 列):
- 提示词列:一段系统提示词(最多 2 万个字符)、平台的一个模型(组织没开通的显示为灰色)和可选的「温度」(0 到 2;空着就是模型的默认值)。项目声明了工具时,「给模型项目的 N 个工具(只记录调用,不执行)」让模型去调它们:调用会显示出来,什么都不执行。「加一列」复制最后一个提示词列;「复制这一列」复制这一列。
- 目标列(「加目标列」,最多一列):项目现在的整个系统,在它的沙盒、测试机或对话 AI 里跑。它只跑场景,所以行要从项目「来自场景」的数据集里抽;它会真的发起一轮测试,和别的运行一样计费。一个项目同一时间只跑一个测试,所以它跑着的时候占着这个项目的测试:「测试新版本」会写明是 Playground 在用,等它跑完。
行
- 「从数据集抽」:选数据集、它的版本(「当前的行」或存过的某一版)、「抽几行」(1 到 100,默认 10)和「种子」。同样的种子抽出同样的行。
- 「粘贴输入」:一行一个输入;用 Tab 隔开的第二段是期望的回答,从表格复制过来就是这样。最多 100 行。
- 实验的一行或一条追踪上的 「在 Playground 打开」:新开一个会话,放着那一行,那次调用的系统提示词和模型作为 A 列。
评分器
「加评分器」从项目的评分器和内置库里选(不含人工和 Agent 行为评分器),最多 20 个。不选评分器只看输出;选了,每一格都有分数,每一列有平均分,A 之后的每一列还和 A 比胜负:「B 胜 A:2 行,输 1 行,平 1」。「只看差异」藏起各列都一样的行。
运行
主按钮上写着这次运行要花多少,「运行 · 约 $0.04」,列下面那一行拆开说:模型按标价加 30%、评分器的评审费用、目标列的沙盒执行(和测试一样,每行每种情况跑 3 次)。点它:每一格跑完就填上,同时跑 4 格。失败的格子写明原因;平台的模型出错的会重试,还是失败就不收费。
目标列的一格就是那一轮实验里的那一行:回复取最后一次有回复的执行,每个分数是判定了的几次的平均(通过两次、判断不了一次,记 1.00,不算未判定),格子下面写着跑了几次。你选的评分器逐次读每次的回复,再同样取平均;没有回复的那次不评。胜负和平均分只算跑完的格子。
运行是人的点击:组织的额度用完时会被拒绝,和别的运行一样(什么时候发不起测试)。
存为实验
「存为实验」把每个提示词列存成一个实验(来源「Playground」,目标「提示词」),第一列作为其余各列的基线;目标列连到它那一轮的实验。存好后页面提示一句,并把链接滚到眼前:每一列的实验、「B 对比 A」(对比页)和「并排看」。再点一次拿回的是同样的实验。
费用
提示词列的每一格是通过 AI Gateway 对平台模型的一次调用:按用量计费,标价加 30%,并记成追踪。评分器按评审用量计费。目标列是一次正常的运行。见价格。